DATA MANAGEMENT
AI学習データとは?必要なデータ量と収集・品質管理・保存・再利用の方法
AI学習データとは、機械学習モデルがパターンや特徴を学ぶために使うデータです。テキスト、画像、映像、音声、センサーログ、業務の記録など、AIの用途に応じてさまざまな形をとります。
AIの精度はアルゴリズムだけでなく、学習データの量と質で大きく変わります。さらに、ロボットや自律機械を動かすフィジカルAIでは、カメラ映像やセンサーデータを継続的に収集し、再学習や検証のために過去のデータも保持するため、保存量が増えやすくなります。学習データは「集めて一度使えば終わり」ではありません。品質、出所、加工履歴を管理しながら長期に保存し、再利用できる状態を保つ必要があります。
この記事では、AI学習データの基本から必要なデータ量の考え方、作り方と品質管理、そして情報システム部門が担う保存・再利用の基盤づくりまでを、クラウドストレージWasabiの視点で解説します。
記事のポイント:
AI学習データの定義と、教師データ・検証データ・テストデータとの違い
必要なデータ量に決まった正解がない理由と、量を見積もる方法
収集から再学習までの7工程と、品質・権利で確認すべき項目
映像やセンサーデータを長期保存し、何度も再利用できる保管基盤の作り方
AI学習データとは
AI学習データとは、機械学習モデルがパターン、関係、特徴を学ぶために使うデータの総称です。例えば教師あり学習では、学習データを繰り返し読み込み、予測と正解のずれが小さくなるように内部のパラメータを調整します。
学習データの質が低いと、どれほど優れたアルゴリズムを使っても期待した精度は出ません。誤ったラベル、偏ったサンプル、現在の用途・利用環境に合わないデータが混ざると、モデルが誤りや偏りを学習するおそれがあります。
学習データと教師データの違い
学習データは、モデルの学習に使うデータ全般を指します。教師データは、教師あり学習の入力と正解ラベルのペアを指すのが一般的ですが、正解ラベルだけを指す場合もあります。本記事では、入力と正解のペアを教師データと呼びます。
教師データ:入力と正解のペア。例として、画像と「不良品」「良品」のラベルの組み合わせ
ラベルなしデータ:人手などで正解ラベルを付けていないテキストや映像。生成AIの事前学習や、教師なし学習で使う
行動と報酬の履歴:ロボットやゲームAIの強化学習で使う
この記事の定義では、教師データは学習データの一部です。生成AIの普及により、人手などで正解ラベルを付けていないデータを学習に使う場面が増えています。
訓練・検証・テストデータの役割
機械学習では、集めたデータを用途ごとに3つに分けて使います。訓練データは「学習データ」とも呼ばれます。
訓練データ:モデルのパラメータを学習させるために使う
検証データ:モデルの設定や、複数の候補から採用するモデルを選ぶために使う
テストデータ:最終的に、未知のデータに対する性能を評価するために使う
テストデータを学習やモデル選択に流用すると、評価結果が実際より良く見えます。重複や類似性の高いデータが訓練用とテスト用にまたがると、評価が過大になるおそれがあります。評価目的に応じて人物・機器ごとの分割や時系列順の分割を選び、分割結果を記録します。
AI学習データの種類
AI学習データは、構造に着目すると構造化・半構造化・非構造化に分けられます。次の表には生成方法による区分の「合成データ」も併記しています。合成データは3つの構造のいずれかになります。
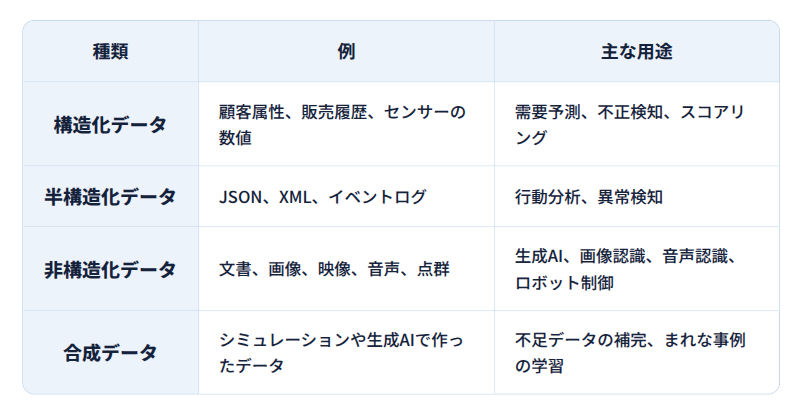
生成AIやフィジカルAIで中心になるのは、文書、画像、映像、音声といった非構造化データです。表の行と列のような共通の構造で整理されていないため、検索、分類、重複の除去、アクセス権の管理が難しくなります。特に映像や音声は容量が大きくなりやすく、保存量の増加にも注意が必要です。
学習方法の違いによっても、必要なデータの形は変わります。
教師あり学習:入力と正解ラベルから学ぶ
教師なし学習:ラベルなしデータから、集まりや潜在的な構造を見つける
自己教師あり学習:データ自体から正解を作り、文章の続きや隠した部分などを予測させる。生成AIの事前学習など
強化学習:状態・行動・報酬などの経験から、累積報酬を大きくする行動を学ぶ
ファインチューニングは、学習済みモデルへの追加学習で、上記の学習方法とは排他的な分類ではありません。なお、RAG(検索拡張生成)で回答生成時に参照する社内文書は、参照だけでは通常モデルのパラメータを更新しないため、学習データとは区別します。ただし、出所、権利、最新性、改ざん防止という管理上の課題は共通しています。
AIに必要な学習データ量の目安
AIに必要な学習データ量に、すべての用途に当てはまる決まった数値はありません。必要な量は、タスクの難しさ、求める精度、データのばらつき、モデルと学習方法によって変わり、実際には「少量で試して増やす」ことで見極めます。
データ量を左右する4つの要因
タスクの難しさ:分類する種類が多いほど、また見分けにくい対象を扱うほど、多くのデータが必要になる
求める精度と許容できない誤り:見逃しが重大な事故につながる用途では、まれな事例まで網羅する必要がある
現場のばらつき:照明、季節、機器の個体差、利用者の違いが大きいほど、条件ごとのデータが必要になる
モデルと学習方法:モデルを一から学習するのか、学習済みモデルを追加学習するのかなどによって、必要なデータ量は大きく変わる
大規模言語モデルについて、DeepMindの研究(Hoffmann et al., 2022)は、計算効率の良い事前学習に向け、モデルの大きさと学習トークン数をほぼ同じ比率で増やす考え方を示しています。Chinchillaは700億パラメータに対し約1.4兆トークンで学習しており、学習トークン数はパラメータ数の約20倍に当たります。ただし、これは特定の計算予算・実験条件に基づく目安で、あらゆるLLMや追加学習に共通する必要量ではありません。
実務での見積もり方は、学習曲線を描くことです。訓練データを2割、4割、6割と段階的に増やし、同じ検証データで性能を確認します。性能が頭打ちなら、データ品質に加え、モデルや学習条件も見直します。伸び続けているなら、データを追加する価値があります。
「量より質」が当てはまる場面・当てはまらない場面
「量より質」とよく言われますが、両者は対立するものではありません。ラベルの誤りや重複が多いデータを増やしても、性能が改善しないばかりか、誤りや偏りを強めるおそれがあります。一方で、まれな事例や現場のばらつきを網羅するには、一定の量がどうしても必要です。
質を優先すべき場面:ラベルの定義があいまい、作業者によって判断が分かれる、現在の用途・利用環境に合わないデータが混ざっている
量を増やすべき場面:学習曲線がまだ伸びている、まれな事例や特定条件のデータが足りない
見落とされやすいのは、量を増やすほど保存と管理の負担も増える点です。データ量の検討は、そのまま保存容量と費用の見積もりにつながります。
フィジカルAIで学習データが急増する理由
フィジカルAIでは、カメラ映像やセンサーデータを継続的に収集し、再学習や検証のために過去のデータも保持するため、保存量が増えやすくなります。フィジカルAIとは、ロボット、自動搬送機、自動運転車のように、現実の空間で認識し、判断し、動くAIを指します。
文章中心の生成AIと比べると、扱うデータの性格が大きく異なります。
映像・点群・センサーログが中心で、1件あたりの容量が大きい
同じ収集条件であれば、現場の機器が増えるほどデータ量も比例して増える
まれな事故や異常の場面ほど価値が高く、後から見返す必要がある
モデルを改良するたびに、過去のデータで性能が落ちていないかを再検証する
どの程度の容量になるのか、カメラ映像で試算してみます。
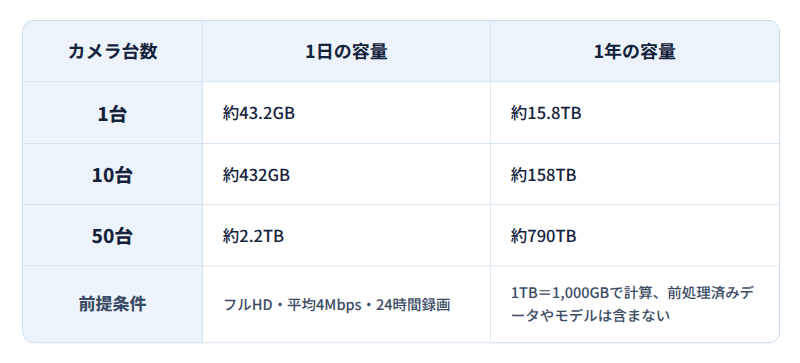
フルHD映像を平均4Mbpsで24時間録画すると、1台あたり1日約43.2GB、1年で約15.8TBになります。50台なら1年で約790TBです(1年365日、1TB=1,000GBとして計算)。ここに前処理済みのデータ、ラベル、学習済みモデルの世代が加わります。
これらのデータは、一度使って終わりではありません。新しいモデルを作るたびに過去の映像を読み出し、まれな事例を探し、テスト用のデータで性能を比べます。フィジカルAIの学習データ基盤では、大容量を長期に保存できることと、繰り返し読み出しても費用を見通しやすいことの両方が求められます。
学習データの作り方:収集から再学習までの7工程
AIセーフティ・インスティテュート(AISI)のデータ品質マネジメントガイドブック(第1.02版、2026年5月)は、データ計画から取得、準備、処理、出力評価、廃棄までを8つのステージで整理しています。この記事では、学習データの整備と運用に焦点を当て、実務上の作業を7工程として紹介します。
利用目的を決める:モデルの用途、対象、必要な精度、許容できない誤りを定義する。同じデータでも用途によって求められる品質は異なる
データを収集する:自社システム、IoT機器、カメラ、購入したデータセット、公開データなどから集める。出所、取得日時、利用条件、同意の有無をメタデータとして残す
クレンジングする:欠損、重複、破損などを確認し、用途に応じて除去や補完を行う。外れ値は重要な異常やまれな事例の可能性があるため、一律に除去しない。原本は上書きせず、処理済みデータを別に保存する
必要に応じてアノテーション(ラベル付け)を行う:画像の領域指定、映像の場面分類、音声の書き起こしなど。ラベルの定義、作業者、作業日、レビュー結果も記録する
訓練・検証・テスト用に分割する:評価目的に応じて人物・機器ごとの分割や時系列順の分割を選び、結果を記録する。補完値や正規化など、データから決める処理条件は分割後に訓練データのみで求め、検証・テストには同じ条件で処理を適用する
モデルとデータの対応を記録する:データセットの版、前処理コード、学習条件と作成したモデルの対応を残す。問題が起きたときに、前の版へ戻せるようにする
監視して必要に応じて再学習する:データの傾向が変わると性能が低下することがある。性能を監視し、必要に応じて再学習する。保持期間を終えたデータは削除する
工程2、3、6では記録が重要です。収集時の出所、原本と加工済みデータの区別、データとモデルの対応関係は、記録がなければ後から復元できないことがあります。
AI学習データの品質管理チェックリスト
AI学習データの品質は、ラベルが正しいかどうかだけでは判断できません。前述のガイドブックは、データ品質特性として正確性、完全性、一貫性、最新性に加え、追跡可能性、監査可能性、代表性、多様性などを挙げています。また、総務省・経済産業省のAI事業者ガイドライン(第1.2版、2026年3月31日公表)も、AI開発者が取り組むべき事項として、学習データの適切な管理やバイアスへの配慮、検証のための記録の保存を示しています。
実務では、次の10項目を点検します。
用途に対して十分な量があるか
欠損、重複、誤ったラベルがないか
実際の利用環境を代表しているか
特定の属性、時期、機器に偏っていないか
現在の用途に対して、データの鮮度や対象期間が適切か
出所と加工の履歴を追跡できるか
権利、同意、利用条件を確認できるか
訓練・検証・テストの間でデータが重複していないか
悪意のあるデータが混入していないか
問題が起きたときに、以前の版へ戻せるか
9番目は、データポイズニングと呼ばれる攻撃への備えです。データポイズニングとは、攻撃者が学習データの一部を追加または改ざんし、モデルに誤った判断や隠れた動作を埋め込む攻撃を指します。
データポイズニングへの対策では、取り込み前の出所・内容・ラベルの検証と、取り込み後の改ざん防止を組み合わせます。保存後の改ざんには、変更・削除の制限、ハッシュ値との照合、追加時の承認手順、アクセス権の制限が役立ちます。後者は、データをどこに、どう保存するかと直結します。
学習データの著作権と個人情報で確認すべきこと
学習データを集める段階では、著作権と個人情報の2点を必ず確認します。保存先の安全性が高くても、収集や利用が適法になるわけではありません。ストレージのセキュリティと、データを使ってよい根拠は、別々に確認する必要があります。
著作権:日本では著作権法第30条の4により、思想や感情の享受を目的としない情報解析は、必要と認められる限度で原則として許諾なく行えます。ただし、享受目的が併存する場合や著作権者の利益を不当に害する場合などは認められないことがあります。文化庁のAIと著作権に関するページでは、考え方の整理とチェックリストが公開されています
収集元の確認:robots.txtなどで示される収集制限や利用規約・ライセンスを守っているか、海賊版と知りながら収集元にしていないかを確認します
個人情報(自社で学習する場合):利用目的の範囲内か、第三者提供の有無、同意などの必要な手続、安全管理措置を確認します
個人情報(外部の生成AIサービスへ入力する場合):個人情報保護委員会は2023年6月、事業者が本人の同意なく個人データを含むプロンプトを入力し、そのデータが機械学習などに使われる場合、個人情報保護法に違反する可能性があると注意を呼びかけています
映像データ:防犯カメラや作業現場の映像には、顔など個人を識別できる情報が含まれます。利用目的の通知や公表、マスキングの方針を収集前に決めます
これらの確認結果は、データと一緒に記録します。どのデータを、どの根拠で、どのモデルに使ったかを後から示せることが、社外からの問い合わせや監査への備えになります。
学習データを保存・再利用するためのストレージ要件
学習データの保存先には、データの増加に合わせて容量を拡張できること、原本と加工済みデータを分けて管理できること、改ざんを防げること、繰り返し読み出しても費用を見通しやすいことが求められます。ここが、情報システム部門が最も関わる部分です。
データレイクの3ゾーンで原本と加工済みデータを分ける
学習データの保管は、データレイクをRaw、Cleansed、Curatedの3つのゾーンに分けて設計すると整理しやすくなります。
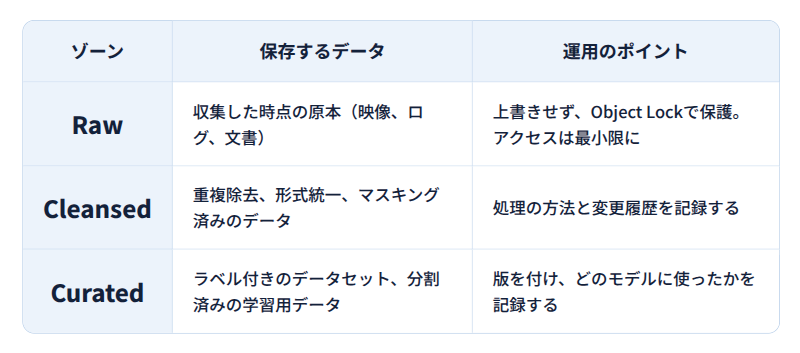
ポイントは、Rawゾーンの原本を上書きせず、クレンジングやマスキングなどの加工はすべてコピーに対して行うことです。原本が残っていれば、前処理の誤りが見つかったときも、ラベルの定義を変えた時も、最初から作り直せます。
ただし、原本には顔や氏名などの個人情報がそのまま含まれることがあります。原本を保存する場合は、Rawゾーンにアクセスできる担当者と用途を厳しく限定し、学習や分析には、マスキングや仮名化をしたCleansedゾーンのコピーを使います。原本の保持は、法令・契約・利用目的のうえで認められる期間内で行うことが前提です。保持期間を過ぎた原本や、削除が必要になったデータは、加工済みのコピーや派生データも含めて削除できるようにしておきます。ゾーン設計の手順は、Wasabiブログのデータレイク構築の手順5ステップで詳しく解説しています。
オブジェクトストレージが保存層に向く理由
学習データの保存層には、オブジェクトストレージが向いています。理由は次の4つです。
クラウドサービスであれば、機器を自社で増設せずに容量を拡張できる
構造化データから映像まで、形式を問わず同じ基盤に保存できる
データごとにメタデータを付けられ、出所や版の管理に使える
S3互換のオブジェクトストレージであれば、S3互換APIに対応するAIツールや分析ツールから読み書きできる
加えて、Object Lockを使えば、保持期間を設定したオブジェクトのバージョンを、変更や削除から保護できます。原本や確定したデータセット、評価結果の改ざん防止に有効です。ただし、Object Lockはバックアップの代わりではありません。また、コンプライアンスモードでは、保持期間中は管理者を含む誰も、保護されたバージョンを削除できません。誤ったデータや、途中で削除が必要になる個人情報をロックすると、個人情報の削除などの要件と矛盾するおそれがあります。ロックの対象は改ざん防止が必要なデータに絞り、個人情報を含むデータに適用する場合は、法令・契約上の保存期間と削除の要件を確認したうえで、対象と保持期間を事前に設計します。
高速な計算層との役割分担
オブジェクトストレージだけで、あらゆるAI処理が速くなるわけではありません。GPUで学習を回す間は、大量のデータを計算処理に合わせて高速に供給する必要があり、データ形式やアクセス方法に応じて、計算環境側のローカルSSDやキャッシュ、並列ファイルシステムなどを組み合わせます。
保存層(オブジェクトストレージ):原本、加工済みデータ、モデルの世代、評価結果を長期に保管する
計算層(GPU環境のSSDやキャッシュ):学習の実行中に使うデータを一時的に置き、高速に読み込む
保存層と計算層を分けておけば、GPU環境を別のクラウドやオンプレミスに切り替えても、データの置き場を変えずに済みます。ただし、計算環境を変える際は、保存層との間の帯域や遅延、ツールやAPIの互換性をあらためて確認する必要があります。
学習データの保存先を自社の環境で試したい場合は、Wasabiの30日間無料トライアルが入口になります。手元の映像やセンサーデータの一部を置き、既存のAIツールからの読み書きと転送速度を確認してみてください。
Wasabiで学習データの保存層を作る場合のポイント
Wasabi Hot Cloud Storageは、保存量に応じて課金されるS3互換のクラウドオブジェクトストレージです。下り転送料とAPIリクエスト料は、それぞれの無料利用ポリシーの範囲内でかかりません。月間の下り転送量がアクティブな保存量以下であることは、下り転送の無料利用ポリシーに適合する目安です。再学習や検証で過去のデータを繰り返し読み出す学習データの保存層では、この料金体系により費用の見通しを立てやすくなります。
Wasabiと他のクラウドストレージの課金項目の違い
下り転送料やAPIリクエスト料を利用量に応じて課金する従来型のクラウドストレージ(AWS S3などの一般的な構成)と比べると、課金項目の考え方が異なります。次の表は課金項目の考え方を比べたもので、実際の料金はサービスごとの無料枠や契約条件、ストレージクラスによって異なります。
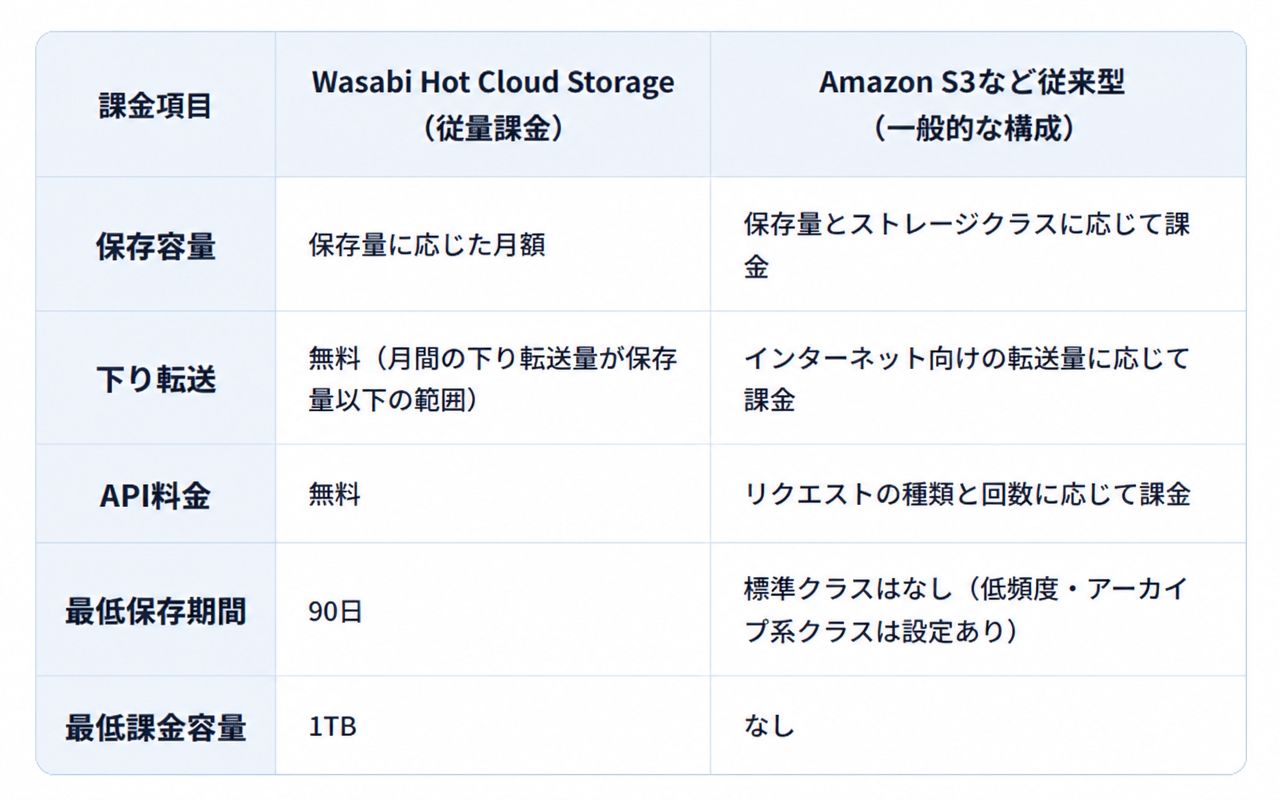
※最低保存期間(90日)は、削除を禁止する期間ではなく課金条件です。従量課金では、保存から90日未満で削除すると、残り期間相当の保存料金が発生します。
※従量課金には最低課金容量(1TB)があり、保存量が1TB未満でも1TB分の保存料金がかかります。
※下り転送料とAPIリクエスト料が無料になるのは、Wasabiの無料下り転送・APIリクエストのポリシーの範囲内(月間の下り転送量が保存量以下で、合理的な頻度でアクセスする使い方)です。条件の詳細はWasabiの料金FAQをご確認ください。
従来型では、学習のたびに別のクラウドのGPU環境へデータを読み出すと下り転送料が、細かなファイルを大量に読み書きするとAPIリクエスト料が積み上がります。学習データの読み出し回数は事前に見積もりにくいため、費用が予算を超えやすくなります。Wasabiが2026年5月に公表した調査では、日本のIT意思決定者250人のうち49%が、2025年のクラウドストレージ費用が予算を上回ったと回答しています(Wasabiによる自社調査。出典:2026年Wasabi Global Cloud Storage Index)。
導入事例:防犯カメラ映像を学習データにするBlack.AI
防犯カメラの映像を検索可能なデータに変えるAI企業のBlack.AIは、映像と学習データへのアクセスの遅さによるAI開発の停滞、データの消失、データ主権に対応できるリージョンの不足、予測しにくいクラウド費用という課題を抱えていました。
同社はWasabi Hot Cloud Storageを導入し、タグ付けした映像とAI学習データを1つの保存先にまとめました。その結果、学習データへのアクセスがボトルネックではなくなり、頻繁なモデル更新に対応する再学習の自動化を実現しています。容量を予約する料金プランにより、予算計画も立てやすくなりました。詳しくはBlack.AIの導入事例をご覧ください。
向いているケースと注意が必要なケース
Wasabiの料金体系が効果を発揮しやすいのは、次のような使い方です。
映像やセンサーデータを数年単位で保存し、必要なときにまとめて読み出す
別のクラウドやオンプレミスのGPU環境から、学習データを読み出す
原本や確定したデータセットを、Object Lockで改ざんから守りたい
一方で、事前に確認しておくべき点もあります。
下り転送料が無料になるのは、月間の下り転送量が保存量以下という合理的使用の範囲です。毎月、全データを何度も外部へ読み出す使い方では、計算環境側にキャッシュを置くなどの設計が必要です
容量を予約しない従量課金プランには、最低保存期間(90日)と最低課金容量(1TB)があります。短期間で頻繁に作り直す一時データは、計算環境側に置く方が適しています
学習の実行中に求められる低遅延の読み込みは、計算層のSSDやキャッシュで補います
立場別:学習データ基盤を検討するときの進め方
学習データ基盤の検討は、立場によって最初に確認すべき点が異なります。
情報システム部門が1〜2名の企業の場合
まず、AI部門や現場がどこにデータを置いているかを棚卸しします。個人のPCや部門ごとのクラウドに散らばった学習データは、権限管理も保持期間も明確でないことが多いからです。管理基盤を統一し、Raw、Cleansed、Curatedに対応するバケットやプレフィックス(フォルダに相当する区分)の構成と命名規則を決めることで、管理の負担を抑えられます。
AI開発・データ分析チームの場合
データセットの版と、モデルとの対応関係を記録する仕組みを優先します。再学習のたびに、どのデータを足し、どのデータを除いたかを残しておけば、精度が落ちたときの原因を追えます。読み出し回数が多くなる前提で、保存先の費用構造も確認しておきましょう。
販売パートナー・SIerが提案する場合
顧客のAI導入の相談では、モデルやGPUの話が先行し、学習データの保存先が後回しになりがちです。カメラの台数や保存期間からデータ量を見積もり、転送・アクセス費用も含めて試算しておけば、保存先の検討漏れを防ぎやすくなります。
AI学習データに関するよくある質問
Q. 学習データの保存費用はどう見積もればよいですか?
A. 原本の容量は「1日に増えるデータ量×保持日数」を基本に見積もり、加工済みデータ、保存するバージョン、モデル、バックアップなどの容量を加えます。総費用には、契約に応じて下り転送、API、最低課金容量、早期削除時の課金なども反映します。計算環境やネットワーク側の費用も確認します。
Q. 学習に使い終わったデータは削除してもよいですか?
A. すぐに削除するのはお勧めしません。学習条件を再現して検証するときや、新モデルとの比較をする時に、当時のデータが必要になるからです。法令・契約・利用目的・監査要件と再利用見込みから保持期間を決め、削除するときは複製や派生データも対象に含めます。
Q. 足りないデータは合成データで補えますか?
A. まれな事故や異常など、現実では集めにくい場面を補う方法として有効です。ただし、合成データには実環境とのずれや偏りが含まれるおそれがあるため、実データとの組み合わせを検討し、実環境での性能はその環境を代表する実データでも評価するとよいでしょう。合成データも、生成条件と版を記録して保存します。
Q. 学習データはデータレイクとデータウェアハウスのどちらに置くべきですか?
A. 映像や画像、文書などを原形式で大量に保存する場合は、オブジェクトストレージを基盤にしたデータレイクが有力な選択肢です。表形式データの集計・分析にはデータウェアハウスが適しています。用途や製品の機能に応じて、両者を使い分けたり組み合わせたりします。
AI学習データの保存と再利用のまとめ
AI学習データとは機械学習モデルがパターンを学ぶためのデータで、教師データはその一部である
必要なデータ量に決まった数値はなく、学習曲線を描いて少量から増やしながら見極める
フィジカルAIでは継続収集と過去データの保持で保存量が増えやすい。平均4Mbps・24時間録画のカメラ50台なら年間約790TB(365日、1TB=1,000GBで計算)
この記事では学習データの整備・運用を7工程で紹介。出所、原本と加工済みデータの区別、データとモデルの対応は、記録がなければ復元できないことがある
品質は正確性だけでなく、代表性、最新性、追跡可能性、権利の状態まで含めて点検する
保存層は原本を守り、利用条件の範囲内であれば繰り返し読み出しても費用を見通しやすいオブジェクトストレージにし、高速な計算層と役割を分ける
学習データを長期に保存し、何度でも再利用できる基盤を
AIの精度を高め続けるには、過去のデータを残し、必要なときに何度でも読み出せる基盤が欠かせません。特にフィジカルAIでは、今日の映像が数年後の再学習で価値を持つことがあります。
Wasabi Hot Cloud Storageは、保存量に応じて課金され、下り転送料とAPIリクエスト料がそれぞれの無料利用ポリシーの範囲内でかからないS3互換のクラウドオブジェクトストレージです。Object Lockによる改ざん防止にも対応しています。AI向けの活用方法はAI・機械学習向けのWasabiで紹介しています。自社のデータ量で費用を試算したい場合はお問い合わせ・資料請求から、まず実データで試したい場合は30日間無料トライアルからご利用ください。

クラウドストレージはランサムウェア対策の要です。イミュータビリティやバージョン管理、隔離コピーで、認証情報が侵害されてもデータを確実に復旧。Covert Copyで迅速な復元を実現する方法を解説します。
AIモデルは安全でも、その土台となるデータパイプラインは無防備になっていませんか?ストレージ層での多層防御が、多くのAIチームに欠けていながら、すべてのAIチームに欠かせない対策である理由を解説します。
製造業のデジタルツインとは、設備や工場を仮想空間に再現し現実と同期させる仕組みです。フィジカルAIとの関係、2026年の動向、導入課題、シミュレーションやAI学習で増えるデータの保管・移動方法まで、情シス目線で解説します。