DATA MANAGEMENT
データレイク構築の手順5ステップ!ゾーン設計からストレージ選定まで徹底解説
データレイクの構築とは、構造化・非構造化を問わず生データをそのままの形式で一元的に蓄積し、分析やAIに活用できる状態を作ることです。
この記事では、これからデータレイクを構築する情報システム部門・データ担当者に向けて、ゾーン設計の考え方と構築手順5ステップを整理します。あわせて、ストレージの選定基準と、「とりあえず貯める」で陥りがちなデータスワンプを防ぐ運用設計まで解説します。
Wasabiの活用事例と、データレイクの土台としての活用ポイントもあわせて紹介します。
記事のポイント:
データレイクとデータウェアハウス(DWH)の役割の違い、レイクハウスとの関係がわかること
Raw・Cleansed・Curatedの3ゾーンでデータレイクを設計する方法
S3互換・耐久性・料金体系など、データレイク用ストレージを選定する基準
「とりあえず貯める」で陥るデータスワンプを防ぐ運用設計の要点
データレイクの基礎知識(構築前に押さえるポイント)
データレイクとは、構造化・非構造化を問わず、生データをそのままの形式で一元的に蓄積するリポジトリ(保管庫)です。構築の前に、データウェアハウスとの役割の違いと、近年の進化形であるレイクハウスまで押さえておきましょう。
データレイクの定義と役割
データレイクの最大の特徴は、データを加工せず「生のまま」保存することです。保存の時点で用途を決めないため、後から新しい分析やAIの学習に同じデータを何度でも使えます。
基幹システムのデータベース、ログ、画像・映像、センサーデータ、文書ファイルなど、形式の異なるデータを1か所に集めます。実装には、容量を柔軟に拡張でき、大容量を安価に保存できるオブジェクトストレージを使うのが標準です。
データレイクが注目される背景には、非構造化データの急増があります。IoTセンサーのログや画像・映像は、従来のデータベースには収まりません。生成AIの普及で、社内文書や音声といったデータも学習・参照の対象として価値を持つようになりました。
「今は使い道が決まっていないが、将来AIや分析に使うかもしれない」データを安価に保全しておく場所として、データレイクは最も現実的な選択肢です。
なお、収集・蓄積・加工・活用というデータ基盤全体の作り方は、関連記事「データ基盤の構築手順5ステップ」で解説しています(※公開後に内部リンク)。この記事は、その中核となる蓄積層=データレイクの構築に絞って深掘りします。
データレイクとデータウェアハウスの違い
データレイクとデータウェアハウスは競合する仕組みではなく、役割が異なります。違いを整理すると次のとおりです。
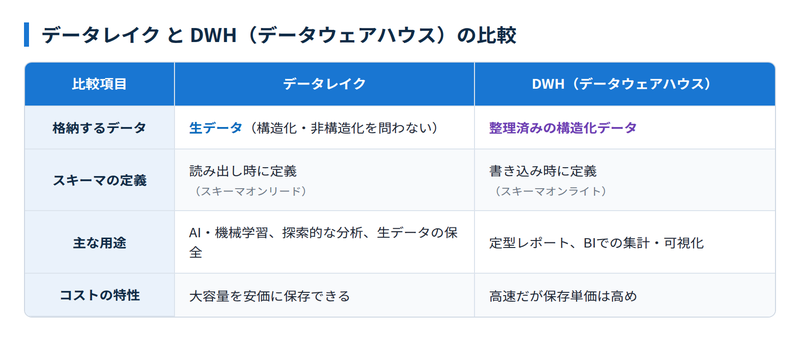
実務では「生データはデータレイクに保全し、分析頻度の高いデータをデータウェアハウスに整理する」という併用が主流です。どちらか一方を選ぶのではなく、データの状態と用途で使い分けます。
たとえば、POSデータの原本はデータレイクに置き、月次集計に使う整形済みデータだけをデータウェアハウスに載せる、という構成です。データウェアハウス側の容量と処理コストを抑えつつ、元データはいつでも遡れる状態を保てます。
レイクハウスの概要と特徴
近年は、データレイクとデータウェアハウスの利点を統合したレイクハウスというアーキテクチャも広がっています。Delta LakeやApache Icebergなどのオープンテーブルフォーマットにより、データレイク上で直接、データウェアハウスのようなデータ管理ができる仕組みです。
ただし、レイクハウスも土台はオブジェクトストレージです。この記事で解説するゾーン設計やストレージ選定の考え方は、レイクハウスへ進化させる場合もそのまま活きます。
データレイクのアーキテクチャ設計(3つのゾーン構成)
データレイクの内部は、Raw(生データ)・Cleansed(整備済み)・Curated(分析用)の3つのゾーンに分けて設計するのが定石です。ゾーンを分けることで、「どこに何があるか」が明確になり、後述するデータスワンプ化を防げます。
3つのゾーンの役割(Raw/Cleansed/Curated)
各ゾーンの役割は次のとおりです。
Rawゾーン:収集した生データを無加工のまま保存する。データの原本として原則削除しない
Cleansedゾーン:形式の統一や重複除去など、クレンジング済みのデータを置く
Curatedゾーン:用途別に加工・集約した、分析やAIで即利用可能なデータを配置する
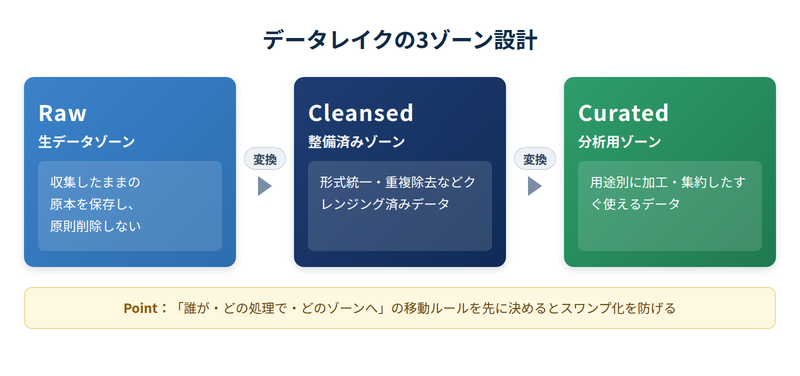
重要なのは、ゾーン間でデータを移動・変換するルールをあらかじめ決めておくことです。「誰が・どの処理で・どのゾーンへ」を定義しておくと、データの出どころをいつでも追跡できます。
ゾーンはアクセス権限の単位としても機能します。Rawゾーンはデータ基盤の担当者だけに絞り、Curatedゾーンは分析者に広く開放する、といった段階的な権限設計が基本です。個人情報を含むデータは、Rawゾーンの時点でマスキングや分離の方針を決めておきます。
なお、3ゾーンは定石であって義務ではありません。小規模に始める場合は、RawとCuratedの2ゾーンから始め、加工処理が複雑になった段階でCleansedを追加する進め方でも問題ありません。大切なのはゾーンの数ではなく、「生データの原本を必ず無加工のまま残す」という原則を守ることです。
ストレージとコンピュート分離の考え方
現代のデータレイク設計では、データを保存するストレージと、処理を行うコンピュート(分析エンジンやAI基盤)を分離するのが基本です。
分離する利点は3つあります。
ストレージと処理能力を、それぞれ必要な分だけ独立に拡張できる
S3互換APIを通じて、複数の分析・AIツールが同じデータに直接アクセスできる
処理側のツールを入れ替えても、蓄積したデータはそのまま使い続けられる
具体的には、S3互換のオブジェクトストレージにデータを置き、Snowflakeのようなデータウェアハウス・分析エンジンやAI基盤から外部テーブルとして参照する構成です。データを分析ツールごとに複製する必要がなく、「唯一の信頼できる情報源」を保てます。
Gartnerは「2026年までに、適切なデータ基盤を持たないAIプロジェクトの60%が失敗する」と予測しています(出典:Gartner)。
データレイク構築の手順(5ステップ)
データレイクの構築は、①ユースケースの絞り込み、②データソースの洗い出しとゾーン設計、③ストレージの選定、④取り込みとカタログの整備、⑤運用・拡張の5ステップで進めます。
ステップ1:ユースケースの絞り込み
最初から「全社のデータをすべて集める」と考えないことが、成功の第一条件です。投資対効果の高いユースケースを1〜2個に絞り、小さく検証(PoC)してから広げます。代表的なユースケースは次のとおりです。
店舗の販売データと在庫データを統合し、需要予測の精度を上げる
設備のセンサーログを蓄積し、故障予兆の検知モデルを作る
散在する契約書・文書を集約し、生成AIで検索・要約できるようにする
PoCの段階で、「何をもって成功とするか」も決めておきます。分析精度そのものより、データが問題なく集まるか、想定どおりのコストで運用できるかを先に確認するのが実務的です。
あわせて、データを提供する現場部門との合意も取り付けます。データレイクは提供部門の協力なしには維持できないため、「何のために・どのデータを・どの頻度で預かるか」を最初に共有しておくと、後の運用が円滑になります。
ステップ2:データソースの整理とゾーン設計
ユースケースに必要なデータソースを特定し、形式・量・増加ペース・更新頻度を整理します。そのうえで、前述の3ゾーン構成に沿って、フォルダ構造と命名規則を設計します。
バケット/フォルダをゾーンごとに分ける(例:raw/cleansed/curated)
データソース名・日付など、一貫した命名規則を決める
個人情報を含むデータの置き場所と、アクセスできる範囲を先に決める
ステップ3:ストレージ選定
データレイクの性能とコストは、土台のオブジェクトストレージでほぼ決まります。選定基準は次章「データレイク用ストレージの選定基準とコスト」で詳しく解説しますが、S3互換API・耐久性・料金体系の3点は必ず確認します。
クラウドを使う場合、環境構築そのものは短期間で済みます。アカウントとバケットを作成し、アクセス権限を設定すれば、その日から取り込みを始められます。
リージョン(データの保管場所)もこの段階で決めます。国内にデータを置きたい要件があるか、災害対策として拠点を分けるかを確認し、利用するストレージが対応しているかを見ておきます。
ステップ4:取り込みパイプラインとデータカタログ整備
データソースからRawゾーンへの取り込みを自動化します。ETL/ELTツールやAPI連携で定期取り込みを設定し、失敗時の再実行と通知も用意します。取り込み方式は、毎回すべてを取り直す全量方式より、前回からの差分だけを取り込む増分方式のほうが、転送量と処理時間を抑えられます。
あわせて、データカタログ(どんなデータが・どこに・どんな形式であるかの目録)を整備します。カタログの整備を後回しにすると、データが増えるほど「何が入っているかわからない」状態に近づきます。
本格運用の前に、小規模な検証で次を確認しておくと安全です。
実データでの取り込み速度と、日次処理が時間内に収まるか
分析ツールからの接続と、ゾーンごとの権限設定が想定どおり機能するか
1ヶ月運用した場合の実際の請求額
ステップ5:運用と段階的な拡張
PoCの検証結果をもとに、対象データとユースケースを段階的に広げます。運用では次を定期的に確認します。
データ量の増加ペースと、ストレージコストの推移
利用されていないデータの棚卸しと、ライフサイクルルールの見直し
新しい分析・AIニーズへの対応と、ゾーン設計の調整
データレイクは、使われるほどデータソースの追加要望が増えます。追加のたびにゾーン設計と命名規則に沿って受け入れる運用を守れるかが、次章で解説するデータスワンプ化を防ぐ分かれ目になります。
データレイク用ストレージの選定基準とコスト
データレイク用ストレージの選定基準は、S3互換性・耐久性・拡張性・料金体系・セキュリティの5つです。中でも見落とされやすいのが、読み出し時にかかる下り転送料・APIリクエスト料を含めた料金体系です。
ストレージ選定の5基準
各基準で確認するポイントを整理します。
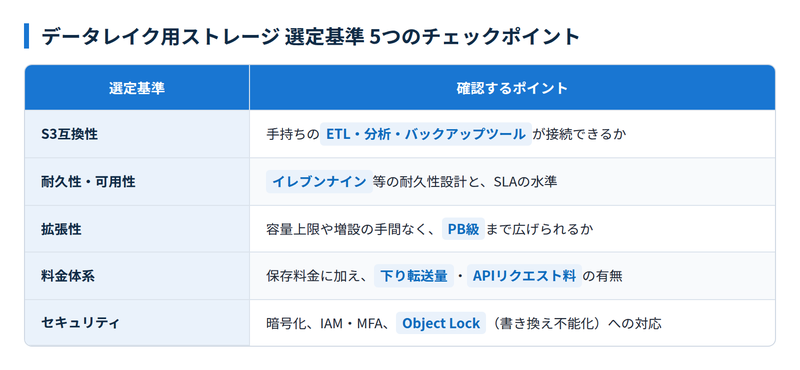
S3互換性を最初に挙げたのは、データレイクが「多くのツールから同じデータにアクセスする」仕組みだからです。S3互換のストレージであれば、ETLツール・分析エンジン・バックアップ製品の多くとそのまま連携できます。
S3互換はベンダーロックインの回避にもつながります。標準的なAPIでデータを置いておけば、将来ストレージや分析ツールを乗り換える場合も、仕組みを作り直さずに移行できます。
読み出し頻度を踏まえた料金体系の選び方
一般的なクラウドストレージの請求は、次の3要素で構成されます。
保存料金:保存しているデータ量に応じた月額
下り転送料:クラウドの外へデータを転送した量に応じた従量課金
APIリクエスト料:データの読み書き操作の回数に応じた従量課金
データレイクは、BIでの集計・機械学習・生成AIの参照など、蓄積したデータを繰り返し読み出す使い方が前提です。特に機械学習では、同じ学習データを何度も取り出してモデルに供給します。読み出すたびに下り転送料やAPIリクエスト料が課金される料金体系では、活用が進むほど費用が読めなくなります。
「学習を回すほどストレージ請求が膨らむため、再学習の頻度を落とす」という本末転倒な事態は、料金体系の選定ミスから起こります。保存単価の安さだけでなく、読み出しコストを含めた総額で比較することが重要です。
当社が提供するWasabi Hot Cloud Storageは、保存データ量だけに課金する単一料金プランで、下り転送料とAPIリクエスト料は一般的な分析・AI用途で発生する読み出し量の範囲で無料です(2026年7月時点)。ハイパースケーラー比で最大80%の低価格を実現しており、読み出しの多いデータレイクの土台に適した料金体系です。
保存量だけに課金される体系なら、コスト試算は「総データ量×単価」で完結します。何度読み出しても追加課金がないため、分析やAIの利用が増えても月額が変わらず、予算計画が立てやすくなります。
契約形態は月ごとの従量課金制と、1年・3年・5年単位の容量予約制(RCS)の2種類です。データの増加ペースが読める場合は、容量予約制でさらに単価を下げられます。
Wasabiをデータレイクに活用する際のポイント
S3互換APIで主要な分析ツールと連携可能。
データ耐久性はイレブンナイン(99.999999999%)
世界16リージョンを展開し、日本には東京・大阪の2拠点(2026年時点)
Object Lockによるデータの書き換え不能化にも標準対応
料金の詳細は料金ページで、分析基盤での活用イメージはデータレイク・分析ソリューションのページでご確認いただけます。自社のワークロードで試したい場合は、30日間の無料トライアルからお試しいただけます。
データスワンプを防ぐ運用設計のポイント
データレイク構築の最大の失敗パターンは、「何が入っているかわからない沼」=データスワンプ化です。原因は技術ではなく、カタログとルールの不在にあります。
スワンプ化を防ぐ運用設計は4つです。
データカタログの維持:新しいデータソースを追加するたびに、目録と担当者を必ず登録する
命名規則とゾーン移動ルール:ゾーン設計で決めたルールを守り続ける体制を作る
ライフサイクル管理:保持期間を決め、不要データのアーカイブ・削除を自動化する
アクセス権限の最小化:ゾーンごと・データごとに必要最小限の権限を付与し、監査ログを残す
カタログには、データの意味に責任を持つ担当者(データオーナー)も記録します。「このデータは何か」を説明できる人を決めておくことが、目録を形骸化させない最も確実な方法です。
ライフサイクル管理では、たとえば「Cleansedゾーンの中間データは90日で削除」「Rawゾーンの原本は保持し続ける」のように、ゾーンごとに保持ポリシーを変えます。原本さえ残っていれば、中間データは必要なときに再生成できるためです。
運用体制としては、四半期に1回程度の棚卸しを定例化するのが現実的です。カタログと実データの突き合わせ、使われていないデータの確認、権限の見直しをまとめて行い、ルールとのずれを早い段階で正します。
利用者側への周知も忘れずに行います。「使いたいデータはまずカタログで探す」「新しいデータを入れたいときは担当者へ申請する」という動線を定着させると、ルールが自然に守られるようになります。
データスワンプ化の兆候
同じデータのコピーが複数箇所に散在している
データの出どころや更新日を誰も説明できない
分析のたびに現場へ「このデータは使えるか」と確認している
1つでも当てはまれば、カタログとルールの整備を優先すべき段階です。
なお、生データの原本を守る観点では、ランサムウェア対策も欠かせません。Object Lockでバックアップを書き換え不能にする方法は、関連記事「データ基盤の構築手順5ステップ」のセキュリティ章で解説しています(※公開後に内部リンク)。
データレイク構築事例(Kaleidoscope社)
分析用データレイクの実例として、米国のコンテンツ分析企業Kaleidoscope社の事例を紹介します。SEC(米国証券取引委員会)提出文書やニュース、SNSなどの非構造化データを毎秒十億語規模で分析し、金融・法務分野の顧客に提供しているスタートアップです。
当社の導入事例としてご紹介している内容は、次のとおりです。
【Kaleidoscope社の導入概要】
課題:毎月約10TB生成される処理済みデータを、顧客へ即時提供できる高速ストレージに保存する必要があった。当初検討したAWSのファイルストレージはコスト面で不適だった
構成:Web上の非構造化データをNimbix社のスーパーコンピュータ(米テキサス州ダラス)で分類・索引化し、処理結果をWasabiに保存。S3互換のオブジェクトストレージから顧客がクライアント経由で即時アクセスする
効果:性能を維持したまま、処理済みデータの保存・配信基盤を低コストで運用
この事例のポイントは、処理段階ごとに最適なインフラを使い分けている点です。計算リソースはNimbix社のスーパーコンピュータ、保存はWasabiと、性能・コスト要件に合わせて選定しています。S3互換APIを土台にすれば、処理基盤と保存基盤が異なる事業者でも同じ仕組みでアクセスできます。
データレイク構築の観点で学べる点は3つあります。
処理段階ごとに、性能とコスト要件に適したストレージを選択できる
S3互換を前提にすれば、処理基盤とストレージが別事業者でもツール側の作り直しが要らない
読み出し頻度の高いデータほど、転送コストのかからないストレージに置く効果が大きい
詳細は当社が公開しているKaleidoscope社の導入事例(英語ページ)でご確認いただけます。
データレイク構築のFAQ
Q. データレイクとデータウェアハウスは、どちらを先に作るべきですか?
A. 近年はデータレイクを先に作る進め方が主流です。生データを先に保全しておけば、後からデータウェアハウスやBIの要件が変わっても、元データから作り直せます。定型レポートの高速化が急務なら、データウェアハウス先行も選択肢になります。
Q. 構築にはどのくらいの期間と費用がかかりますか?
A. ユースケースを絞ったPoCなら1〜2ヶ月程度で始められます。費用の中心は、継続的にかかるストレージ費用とETL/分析ツールの利用料です。ストレージはデータ量に比例して増えるため、保存単価と読み出し課金の有無を最初に確認しておきます。
Q. オンプレミスでもデータレイクを構築できますか?
A. 構築自体は可能ですが、PB級まで見据えた拡張性と初期投資の観点から、クラウドのオブジェクトストレージが主流です。規制などで社外に出せないデータがある場合は、そのデータだけオンプレミスに残すハイブリッド構成も取れます。
Q. 小さく始めるにはどこからですか?
A. ユースケースを1つ選び、関係するデータソースだけでRawゾーンから作るのが最小構成です。S3互換ストレージにバケットを作り、取り込みを自動化するだけでも、生データの保全という価値が生まれます。
Q. ファイルサーバーにデータを集めるのと何が違いますか?
A. データレイクはAPI経由でシステムからアクセスする前提の仕組みで、分析・AIツールとの連携やPB級への拡張が容易です。ファイルサーバーは人が開く用途に向きますが、大規模データの分析基盤には向きません。
迷ったら「生データの保全」から始めるのが安全です。捨てたデータは二度と学習や分析に使えませんが、貯めたデータは後からいくらでも活用方法を変えられます。
まとめ(データレイク構築成功のポイント)
データレイクとは、生データをそのままの形式で一元的に蓄積する分析・AI基盤の中核である
内部はRaw・Cleansed・Curatedの3ゾーンで設計し、移動ルールと命名規則を先に決める
構築はユースケースの絞り込みから始め、PoCで小さく検証してから段階的に広げる
ストレージはS3互換・耐久性・拡張性・料金体系・セキュリティの5基準で選定する
読み出しの多いデータレイクでは、下り転送料のかからない料金体系がコストを安定させる
カタログ・命名規則・ライフサイクルの運用設計で、データスワンプ化を防ぐ
AI・分析の土台となるデータレイクを、Wasabiで
Wasabiのデータレイク・分析ソリューションページでは、S3互換オブジェクトストレージを土台にしたデータレイク構成、主要な分析・AIツールとの連携、下り転送料・APIリクエスト料が発生しない料金体系のメリットについてご確認いただけます。

クラウドストレージにおける責任共有の実践的な整理。プロバイダーが担当する内容と、リスクを低減しインシデント対応を迅速化するために顧客が管理すべき内容を含みます。アクセス制御、保持、変更不可性、暗号化、および Covert Copy を扱います。
サステナビリティ経営でIT部門にもCO2削減が求められています。オンプレミス環境が電力を浪費する要因と、クラウド移行が排出量削減につながる仕組みをPUEなどの指標から解説。省エネ設計のデータセンターを基盤とするWasabiの取り組みも紹介します。
2026年版Wasabi Global Cloud Storage Indexでは、クラウドストレージのコスト、AI対応状況、セキュリティについて、大学・高等教育機関のIT意思決定者241人を対象に調査を行いました。これが、高等教育におけるクラウドストレージの意思決定にとって何を意味するのかをご紹介します。